はじめに
最近、ChatGPTをはじめとする「生成AI」のニュースを毎日のように見かけますよね。でも、そのとてつもなく賢いAIが、裏側でどうやって動いているのか想像したことはありますか?
実は、現代のAIの進化の裏側には、私たちがよく知る「ある身近なもの」が深く関わっています。それはなんと、家庭用ゲーム機の「PlayStation(プレイステーション)」です!
「えっ、ゲーム機と最新のAIにどんな関係があるの?」と驚かれるかもしれません。実はコンピュータの世界には「分散コンピューティング」と呼ばれる、たくさんのコンピュータを繋ぎ合わせて一つの巨大な計算機のように扱う、魔法のような技術があるのです。
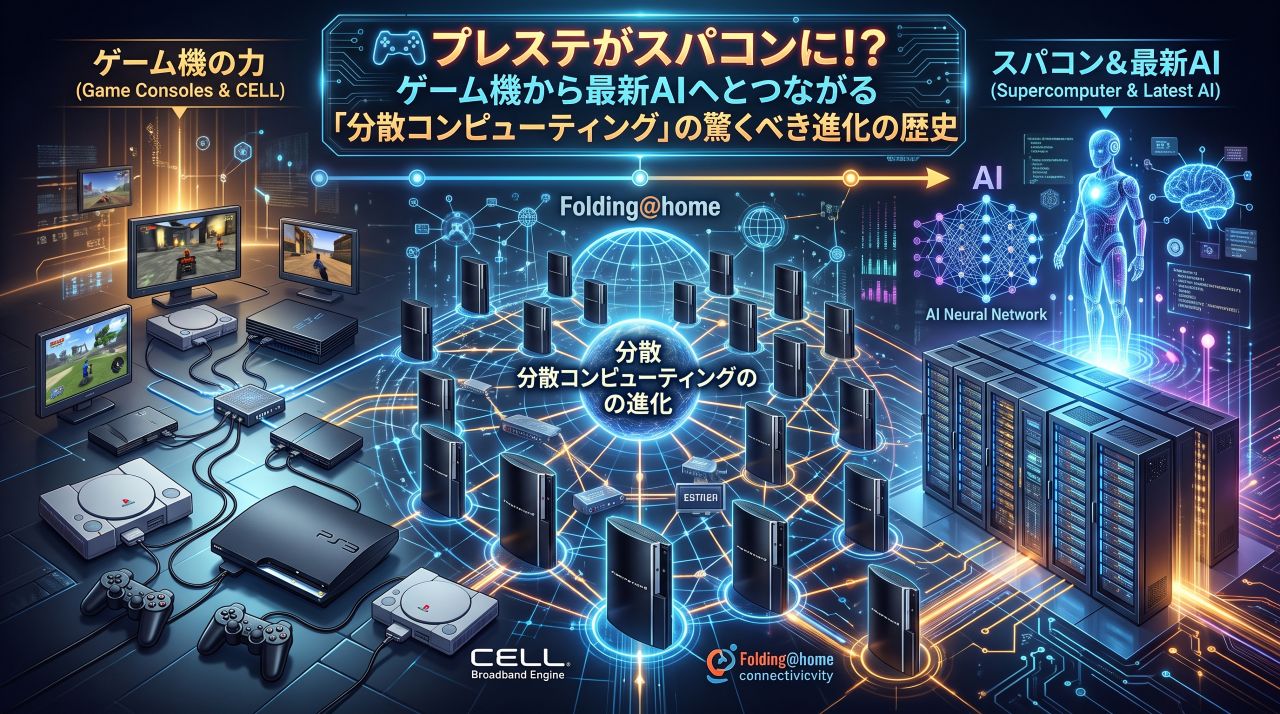
本記事では、ゲーム機をつないでスーパーコンピュータを作っていたロマンあふれる時代から、最新のAIを支える超高度なネットワーク技術まで、その驚くべき進化の歴史をわかりやすく解説します。専門用語はできるだけ噛み砕いて説明しますので、パソコンに詳しくない方も安心してお読みいただけます。
👇 本記事でわかる3つの重要ポイント 👇
- 【テーマ1】PlayStationが軍事用スーパーコンピュータとして使われた驚きの理由
- 【テーマ2】家庭のパソコンが最新AIの基礎となった「分散コンピューティング」の秘密
- 【テーマ3】最新の生成AIを動かすために必要な「GPU同士の会話」の仕組み
この記事を読み終える頃には、私たちが何気なく使っているAIの裏側で、どれほどとてつもない技術が動いているのかがはっきりと分かり、毎日のITニュースがもっと面白く感じられるはずです。それでは、ゲーム機がスパコンになった時代へ、さっそくタイムスリップしてみましょう!
1. ゲーム機が軍事用スパコンになった!?PlayStationを活用した驚きの計算システム
PlayStationを連結したスーパーコンピュータや、世界中のPCをつないで計算を行う分散コンピューティングプロジェクトは現実に実在しており、科学史やコンピュータ史に多くの重要な記録を残しています。
PlayStation 2やPlayStation 3は、当時としては破格の「浮動小数点演算能力(小数点を含む複雑な計算を素早くこなす能力)」を備えており、多くの研究者や軍事機関が並列計算機(クラスタ)として実際に活用しました。
米空軍が構築した1,760台のPS3の集合体「コンドル・クラスタ」
2010年、アメリカ空軍研究所(AFRL)は、なんと1,760台ものPlayStation 3を接続して構築したスーパーコンピュータ「コンドル・クラスタ(Condor Cluster)」を完成させました。
このシステムのピーク性能は約500テラフロップスにも達し、当時の国防総省内でもトップクラスの演算能力を誇っていました。主な用途としては、衛星画像や航空写真の高解像度化処理、そしてレーダー信号の処理などに使われていたのです。
なぜ専用のコンピュータではなくゲーム機が選ばれたかというと、驚異的なコストパフォーマンスに理由があります。同等のスーパーコンピュータを専用機で組む場合と比べ、なんと約10分の1から20分の1の費用で済み、電力消費も約10分の1に抑えられたからです。
このような離れ業が実現した背景には、初期型のPS3には公式にLinuxなどの別のOS(基本ソフト)を導入できる「OtherOS」という機能が備わっていたことが挙げられます。しかし、その後のファームウェアアップデートによる機能の削除や、薄型のSlim型での非対応化、そして現代の主流となるGPUによる汎用計算(GPGPU)の台頭によって、PS3クラスタの時代は静かに幕を閉じました。
さらに遡る!PS2を70台繋いだ初期のプロジェクト
PS3の時代よりも前、2003年にはアメリカの国立スーパーコンピュータ応用研究所(NCSA)が、PlayStation 2を約70台接続したクラスタを構築したという記録も残されています。当時から、家庭用ゲーム機の秘めた計算能力は研究者たちにとって非常に魅力的な存在だったことがわかります。
2. 世界中の家庭用PCが協力!「ボランティア・コンピューティング」の熱狂
インターネットを経由して、世界中の家庭用PCやゲーム機の余っているCPUやGPUのパワーを集約し、1台のパソコンでは不可能なほど巨大な計算をみんなで分担させる仕組みを「ボランティア・コンピューティング(グリッド計算)」と呼びます。この取り組みは1990年代末から広く行われ、一大ムーブメントを巻き起こしました。
宇宙人を探せ!数百万人が熱中した「SETI@home」
1999年にカリフォルニア大学バークレー校が開始した「地球外知的生命体探査」のプロジェクトが「SETI@home(セティ・アット・ホーム)」です。
アレシボ天文台などが観測した膨大な電波データを細かく分割し、世界中の参加者のPCにインターネット経由で配信する仕組みでした。ユーザーがPCを使っていない時間(スクリーンセーバーが起動している間など)に、バックグラウンドでこっそりと解析を行ってくれました。世界中から数百万人が参加し、まさに分散計算の代名詞とも言える存在となりました(現在は2020年に新規データの配布を休止しています)。
医療の未来を救う「Folding@home」とPS3の活躍
「Folding@home(フォールディング・アット・ホーム)」は、スタンフォード大学が立ち上げた医療系プロジェクトです。タンパク質の折りたたみ構造(フォールディング)をシミュレーションすることで、アルツハイマー病やがん、感染症などの治療薬研究に役立てることを目的としています。
実はここにも、PS3が深く関わっています。ソニーの強力なバックアップにより、PS3のメニュー画面(XMB)から直接ワンタッチでこのプロジェクトに参加できるクライアントソフトが提供されていました。「Cell Broadband Engine」と呼ばれるPS3の心臓部の驚異的な計算速度により、プロジェクト全体の演算能力の大半をPS3ユーザーが支えていた時期があったほどです。
さらに、2020年の新型コロナウイルス流行時には、病気の解明のために世界中からものすごい数の計算資源が集まりました。その結果、世界初の「エクサフロップス(毎秒100京回の計算)」という天文学的な壁を突破した分散システムとして、ギネス級の記録を樹立しています。
最大の素数を見つけ出す「GIMPS」
「GIMPS(Great Internet Mersenne Prime Search)」は、巨大なメルセンヌ素数を発見するための分散計算プロジェクトです。現在発見されている最大の素数の多くは、一人の天才の頭脳や1台の巨大コンピュータではなく、世界中のPCを連携させたこのネットワークによって見つけ出されています。
3. 現代社会を裏側で支える分散コンピューティングの現在地
家庭用ゲーム機を何千台もラックに並べた光景や、スクリーンセーバーで宇宙からの電波を解析していたあの頃の体験は、専用スパコンがまだ非常に高価だった時代ならではの、ロマンと工夫が詰まった歴史的なプロジェクトでした。
しかし、現代のコンピュータの世界でも分散コンピューティングは当たり前のように行われており、むしろ現代社会の最先端技術を支える「絶対的な基盤」になっています。現代の高性能スーパーコンピュータやクラウド基盤そのものが、「超高性能な計算機を何万台も超高速ネットワークで繋いだ巨大な分散システム」であり、決して単体(1ノード)のコンピュータで動いているわけではないのです。
① ChatGPTなどの「生成AI・大規模言語モデル(LLM)」の学習
現代において、最も象徴的で活発な用途がこれです。ChatGPTなどに使われている大規模言語モデルは、パラメータと呼ばれる脳のシナプスのような設定値が数千億から数兆という途方もない数に達しています。そのため、モデルのデータや計算途中の情報を、たった1台のGPUのメモリに収めることは物理的に不可能です。
そこで、「テンソル並列」や「パイプライン並列」といった手法が使われます。これは1つの巨大なニューラルネットワークの層(レイヤー)や数式自体を細かく分解し、数千から数万基ものGPUに分散させて協調計算させる技術です。
また、「データ並列」と呼ばれる手法では、膨大な学習用のテキストデータを分割し、多数の計算ノード(コンピュータ)に同時に読ませて、学習結果(勾配)を定期的に同期して統合しています。
② 天気予報や地球規模の「気候シミュレーション」
毎日の天気予報や台風の進路予測、地球温暖化のシミュレーションは、「地球の大気や海洋を数キロ四方の立方体(グリッド)に分割」して、流体力学の難しい偏微分方程式を解くことで行われています。それぞれの空間が隣の空間とどう影響し合うか、グリッドの境界データだけをコンピュータ間で通信しながら、何万ものCPUやGPUがそれぞれの担当する空間の気圧や気温変化を並列に計算しています。
③ Googleなどの「ビッグデータ解析と検索エンジン」
Googleの検索インデックスの生成や、金融機関のクレジットカード不正検知、AmazonなどのECサイトのおすすめ(レコメンド)機能などは、テラバイトからペタバイト級(ギガバイトの100万倍)のデータを処理しています。単一の超大型マシンで処理するのではなく、「Apache Spark」などの分散処理の仕組み(フレームワーク)を使い、数千台の標準的なサーバーにデータを細かく分けて渡し、一斉に検索や集計をさせています。
④ 新薬を開発するための「創薬シミュレーション・生体分子解析」
かつての「Folding@home」の流れを汲む計算も、現代は製薬企業や研究機関が持つ専用のクラスタ上で行われています。新薬の候補となる化合物が、ウイルスの標的タンパク質にどのように結合するか(ドッキングシミュレーション)を何百万通りものパターンに分け、一気に並列計算させています。
⑤ ハリウッド映画を裏で支える「CG映像のレンダリング」
ハリウッド映画やフル3DCGアニメの美しい映像制作では、「レンダーファーム(Render Farm)」と呼ばれる専用の巨大な分散システムが使われます。1フレーム(1コマ)を描画するだけで数時間かかるような複雑な光の反射計算を、数千台のサーバーにフレーム単位や画面領域単位で割り振り、一晩で数万フレームもの映像を同時に書き出しています。
4. かつての「余った力の寄せ集め」から現代の「巨大なAIの神経網」への進化
昔のボランティアコンピューティングと現代のAIシステムでは、構成が大きく異なります。わかりやすく比較表にまとめました。
| 比較項目 | かつて(PS3やSETI@home等) | 現代(AI学習・最新スパコン等) |
|---|---|---|
| 接続形態 | 一般の家庭用回線(低速・通信に時間がかかる) | 専用の超高速光接続(InfiniBandなど) |
| 計算の性質 | お互いに通信が不要な「独立タスク」(各自が自分のペースで作業) | 1ミリ秒単位で全員が計算結果を持ち寄る「密結合タスク」(息を合わせた連携作業) |
| 主役 | 余剰PCのCPUやCellプロセッサ | クラウド上のAIアクセラレータやGPU |
かつては「家庭の余ったパワーを緩く集める」という形態が話題になりましたが、現代は「1つの巨大な頭脳を作るために、高密度データセンター内で何万台ものプロセッサを神経網のように直結して動かす」という形で、より高度に進化しています。
現代のテクノロジーで「1台の超高速コンピュータ」と思われているもののほぼ全ては、裏側で無数のコンピュータが手を取り合って動く分散システムなのです。
5. なぜ最新のAI学習では「GPU同士の会話」がそんなに重要なのか?
AIの大規模学習(LLMなど)において、GPU自体の計算速度と同じくらい、あるいはそれ以上に重要視されるのが「GPU同士を繋ぐネットワークの速度」です。
どれほど計算が速い最高級のGPUを何万台並べたとしても、ネットワークが遅ければ「通信待ち」の状態になり、GPUの計算ユニットが遊んでしまいます。その結果、システム全体の効率が数分の一にまで激減してしまうからです。
大規模な分散学習では、主に次の2つのような「GPU同士の通信」が、ミリ秒単位で絶え間なく発生しています。
① 全員で結果を持ち寄る同期「All-Reduce通信」
各GPUがそれぞれ異なるテキストデータ(データ並列)を読み込んで計算を行った後、「AIの頭脳の数値をどの方向に修正すべきか(勾配)」という結果を、全GPU間で合計して共有しなければ、次のステップに進むことができません。みんなで一度作業の手を止めて、会議をして方針を合わせるようなイメージです。
② モデルの輪切りによる「バケツリレー(テンソル/パイプライン並列)」
巨大なAIモデルは1台のGPUに入り切らないため、ニューラルネットワークの層(レイヤー)や計算自体を分割します。手前の層を担当するGPUの計算結果を、次の層を担当するGPUへ即座に転送し続ける必要があります。少しでも渡すのが遅れると、次の人がずっと待機することになるため、超高速のバケツリレーが求められます。
6. 家庭用のインターネットLANケーブルではAI開発ができない理由
一般的なパソコンやサーバーで使われているネットワーク通信(イーサネット)では、AI学習には全く歯が立ちません。そこには2つの巨大なボトルネック(障害)が存在するからです。
① CPUとOSのオーバーヘッド(プロトコル処理)
通常の通信では、データを送る際に「GPUメモリ → メインメモリ(RAM) → OSカーネル/CPU → LANカード」と、幾重にもデータをコピーして受け渡す必要があります。これは例えるなら、部署間で書類を渡すたびに、いくつものハンコをもらって決裁を通さなければならないようなもので、CPUの負荷と遅延(レイテンシ)が跳ね上がってしまいます。
② 帯域幅(通信の太さ)の圧倒的な不足
一般的なサーバー用のイーサネット(10Gbps〜25Gbpsなど)の通信速度では、AIの計算で毎ステップごとに数百ギガバイトから数テラバイトものデータが飛び交う状況に全く追いつけません。細い路地に、大量のダンプカーを走らせようとして大渋滞を起こすようなものです。
7. 最新AIクラスタの心臓部!「NVLink」と「InfiniBand」の凄さとは
こうした大渋滞を防ぐため、最新のAIクラスタでは「箱の中(同一サーバー内)」と「箱の外(サーバー間)」で、全く異なる専用の超高速通信規格を組み合わせて使っています。
① 箱の中の神経網:「NVLink(エヌブイリンク)」と「NVSwitch」
「NVLink」は、1台のサーバー筐体(箱)に載っている8基から数十基のGPU同士を、超高密度に直接結びつける技術です。
通常のパソコンの部品をつなぐ規格(PCIeスロットなど)の制約を飛び越え、双方向で毎秒数百GBから数TBという、メモリに直接書き込むのに近い圧倒的な通信の太さ(帯域幅)を実現しています。
さらに「NVSwitch」という専用の通信切り替えチップを介することで、8基すべてのGPUがあたかも「1つの巨大なメモリ空間を持った単一のスーパーGPU」であるかのように振る舞うことができます。
② 箱をまたぐ幹線道路:「InfiniBand(インフィニバンド)」
サーバー単体の枠を超え、ラック間や巨大なデータセンター内に並ぶ数千台から数万台のサーバー(ノード)同士を結ぶための専用ネットワークが「InfiniBand」です。
400Gbpsから800Gbpsクラスという超高速通信を、1マイクロ秒(100万分の1秒)未満という極小の遅延で届けます。
さらに素晴らしいのが「完全ロスレス(パケットロスなし)」という特徴です。通常のネットワークは通信が混雑すると、データを一旦捨てて後から「再送」を求めますが、InfiniBandはハードウェア制御でパケットの喪失をゼロにし、データの再送待ちによるAI学習のストップを完全に防ぎます。
8. コンピュータの限界を超える核心技術「RDMA」の魔法
InfiniBandやNVLinkの凄さを語る上で欠かせないのが「RDMA(Remote Direct Memory Access)」、特にGPU専用に作られた「GPUDirect RDMA」という技術です。
この技術の最大の特徴は、通常の通信とは異なり、CPUやメインメモリ、OSカーネルといった「面倒な決裁ルート」を**完全にバイパス(迂回)**してしまうことです。
具体的には、サーバーAのGPUメモリにあるデータを、サーバーAのLANカード(NIC)が直接読み取り、ネットワークを経由してサーバーBのLANカードから、直接サーバーBのGPUメモリへと書き込みます。間にいるCPUには一切の仕事をさせません。
これにより、CPUに一切負荷をかけず、無駄なデータのコピーも発生しないため、通信の遅延が極限まで最小化され、GPUが持つパワーの限界ギリギリまで計算スピードを引き出すことができるのです。
| 比較ポイント | 一般的なネットワーク | AI専用ネットワーク(NVLink + InfiniBand) |
|---|---|---|
| 遅延(レイテンシ) | 数ミリ秒(AIにとっては非常に遅い) | マイクロ秒単位(超極小・一瞬) |
| CPU負荷 | 通信処理のせいでCPUが高負荷に | ほぼゼロ(RDMA技術で完全に迂回) |
| データの流れ | GPU → RAM → CPU → LANカード | GPUメモリ ⇄ GPUメモリ (直接転送!) |
| パケット喪失 | 混雑時にデータを捨てて再送が発生する | ロスレス転送(再送待ちなしでスムーズ) |
最新のAIデータセンターが、数万個のGPUだけでなく、数万台のスイッチと数万本の光ファイバーで埋め尽くされているのは、まさにこの「GPU間の通信渋滞をゼロにするため」だったのです。
まとめ
本記事では、家庭用ゲーム機のPlayStationをつなぎ合わせて軍事用スパコンを作っていたロマンあふれる時代から、現代の超高性能な生成AIを支える最先端のネットワーク技術まで、「分散コンピューティング」の驚くべき進化の歴史をご紹介しました。
かつては「世界中で余っているパソコンの力を少しずつ借りて、なんとか巨大な計算をしよう」という草の根のボランティアから始まった技術でした。それが今や、マイクロ秒を争う超高速専用ネットワーク(NVLinkやInfiniBand)や、CPUを完全に無視してデータを直接送り合う技術(RDMA)へと劇的な進化を遂げ、高密度なデータセンターの中で一つの巨大な頭脳を形成しています。
私たちが普段何気なくスマートフォンやパソコンで使っているChatGPTなどの生成AIの裏側には、何万基ものGPUが寸分の狂いもなく、ものすごいスピードで対話をし続ける「究極の分散システム」が息づいています。次にAIが驚くような回答を出してきたときは、海の向こうのデータセンターで無数のGPUたちが高速でバケツリレーをしている姿を、ぜひ想像してみてくださいね。