はじめに
普段何気なく使っている言葉や、テレビ・SNSで見かける流行語を見て、「この言葉はいつ頃から使われ始め、昔の人はどんな言葉を口にしていたのだろう?」と疑問に思ったことはありませんか。私たちが使う言葉の移り変わりには、その時代を生きた人々の関心や社会の大きな変化が、そのまま記録されています。もし、過去数百年分の膨大な書籍から言葉の歴史をグラフにして、当時の「世相」や「時代の空気」をタイムマシンのように覗き見ることができるとしたら、とてもワクワクしませんか。
👇 本記事でわかる3つの重要ポイント 👇
- 【テーマ1】言葉の並びを数える仕組み「Nグラム」の基本とデジタル分析の凄さ
- 【テーマ2】数千万冊の文献から流行語の盛衰を可視化する「Google Books Ngram Viewer」の魅力
- 【テーマ3】言葉のグラフから歴史の転換点や人々の関心の変化を読み解く具体的な面白さ
専門的な難しい数式やプログラミングの知識がなくても、仕組みさえ知ってしまえば、誰でも手軽に言葉のタイムトラベルを楽しむことができます。この記事を通して、言葉の移り変わりが教えてくれる歴史の深みと、ビッグデータが明かす意外な事実を一緒に探っていきましょう。
言葉の並びを切り分ける「Nグラム」の基本的な仕組み
「Nグラム(N-gram)」という言葉を初めて耳にすると、なんだか難解な専門用語のように感じられるかもしれません。しかし、その根本にある考え方はとてもシンプルで、文章を特定の単位ごとに細かく区切っていく手法のことです。
私たちの日常会話や文章は、たくさんの単語や文字が順番に連なって成り立っています。Nグラムの「N」は任意の数字を表しており、文章を構成する要素を「いくつの塊として取り出すか」を意味しています。文字単位で区切る場合もあれば、単語単位で区切る場合もありますが、いずれも文章を機械が扱いやすいように一定のルールで切り分けるために使われます。
文字単位で見るNグラムの具体例
たとえば、「きょうのてんき」という平仮名7文字のフレーズを考えてみましょう。このフレーズを数字の大きさに合わせて切り分けると、次のような違いが生まれます。
- 1文字ずつ(ユニグラム / 1-gram):「き」「ょ」「う」「の」「て」「ん」「き」と、すべての文字を1文字ずつバラバラに分解します。
- 2文字ずつ(バイグラム / 2-gram):「きょ」「ょう」「うの」「のて」「てん」「んき」と、隣り合う2文字を窓枠のようにずらしながら取り出していきます。
- 3文字ずつ(トライグラム / 3-gram):「きょう」「ょうの」「うのて」「のてん」「てんき」と、3文字ずつの組み合わせとして切り出します。
このように並びを崩さずに少しずつずらしながら拾い集めることで、どの文字とどの文字がよく一緒に登場するのかを漏れなく調べることができるようになります。
単語単位で切り分ける欧米言語と日本語の違い
英語をはじめとする欧米の言語では、単語と単語の間に最初からスペース(空白)が入っているため、単語ごとに数える「単語単位のNグラム」がとても扱いやすいという特徴があります。たとえば、「I love reading books」という英文であれば、1単語なら「I」「love」「reading」「books」、2単語の組み合わせなら「I love」「love reading」「reading books」という形で綺麗に取り出すことができます。
一方、日本語は単語同士が空白で区切られていないため、まずは文章を意味のある最小の言葉に切り分ける作業が必要になります。現代のデジタル技術では、コンピューターが辞書を参照しながら日本語を単語ごとに分割し、その上でNグラムとして集計することが可能になっています。
膨大な書物をデータに変えた「Google Books」の革命
Nグラムという分析手法が、単なる研究室の技術にとどまらず、一般の歴史や文化の探究にまで広く使われるようになった背景には、世界中の本を電子化するという巨大なプロジェクトの存在があります。
Google社は2000年代初頭から、世界各国の大学図書館や公共機関と協力し、人類がこれまでに印刷・出版してきた数多くの書物をスキャンしてデジタルデータ化する取り組みを始めました。この途方もない作業によって集められた書籍の数は数千万冊、ページ数にして数十億ページ以上にも及びます。英語だけでなく、フランス語、ドイツ語、スペイン語、ロシア語、中国語、日本語など、多言語にわたる膨大な文献が文字データとして蓄積されることになったのです。
本がデータ化されることで起きた変化
かつて、ある言葉が歴史上どのように使われてきたかを調べようとすると、研究者が図書館に長期間通い詰め、分厚い古文書を1ページずつ手作業でめくりながら探すしかありませんでした。そのため、個人の記憶や限られたサンプルの範囲でしか言葉の歴史を語ることができませんでした。
しかし、何千万冊もの書籍がすべて文字データに変換されたことで、「過去数百年間に印刷された本の中で、特定の言葉が合計で何回印刷されたか」を、コンピューターを使って瞬時に数え上げることができるようになったのです。これは、言語学や歴史学における革命的な出来事でした。
流行語の歴史をグラフ化するツール「Google Books Ngram Viewer」
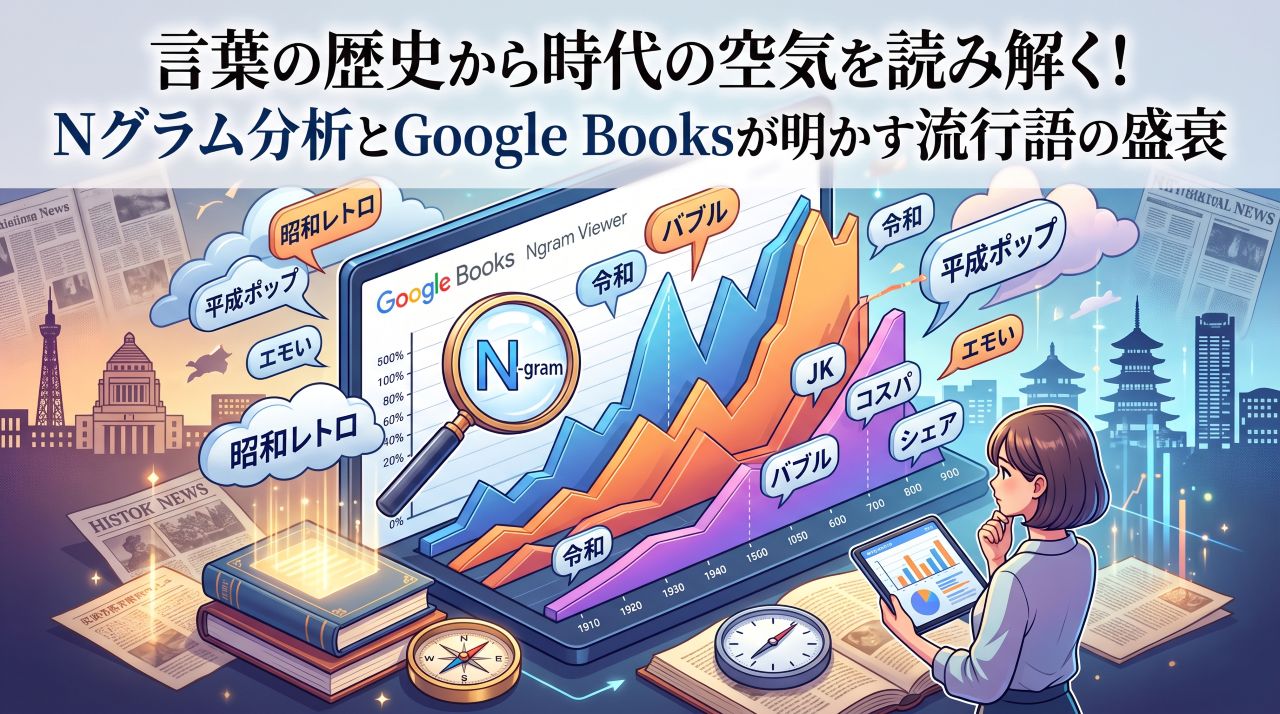
こうした膨大な書籍データベースを誰でも手軽に探索できるように一般公開されたWebサービスが、「Google Books Ngram Viewer(グーグル・ブックス・エヌグラム・ビューワー)」です。
使い方はとても簡単で、検索窓に自分が調べたい言葉を入力して年代の範囲を指定するだけです。すると、画面上に横軸が「西暦(年代)」、縦軸が「その年に出版された本全体の中で、その単語が登場した割合(出現頻度)」を示した折れ線グラフが即座に描き出されます。
単なる件数ではなく「割合」で見る意味
このツールの非常に優れている点は、単に出現回数の合計を棒グラフにするのではなく、「その年全体の出版語数に対する割合」として計算してくれるところです。
出版産業は時代が進むにつれて急速に拡大しており、1800年に出版された本の数と、2000年に出版された本の数では、何千倍・何万倍もの差があります。もし単なる出現回数だけで比較してしまうと、どんな単語であっても現代に近づくほど急増しているように見えてしまいます。全体の出版語数で割り算を行い、パーセンテージ(出現頻度)としてグラフ化することで、過去と現在を同じ基準で公平に比較し、その言葉が本の中でどれくらい重要な位置を占めていたのかを正しく浮き彫りにすることができるのです。
折れ線グラフから「時代の空気」を読み取る面白さ
実際にNグラムのグラフを眺めてみると、言葉の盛り上がりと衰退が、歴史上の重大な出来事や人々の価値観の変化と見事に連動していることがよく分かります。言葉はただの文字記号ではなく、その時代に生きた人々の感情や関心の集合体であることが実感できます。
戦争や世界的な危機と連動する言葉
歴史的な大事件は、人々の言語空間に強烈な足跡を残します。たとえば、英語の書籍データで「war(戦争)」や「peace(平和)」という単語を検索してみると、第一次世界大戦が勃発した1914年前後と、第二次世界大戦が激化した1939年から1945年にかけて、グラフの線が目を見張るほどの鋭い山を作ります。平時には低水準で推移していた言葉が、危機に直面した瞬間に社会全体を覆い尽くしていた様子が、一目瞭然で伝わってきます。
同様に、「influenza(インフルエンザ)」という単語を調べてみると、世界中で猛威を振るった1918年のスペインかぜの時期に突出したピークが現れます。当時の社会がどれほどの恐怖と関心を持ってその感染症に向き合っていたかが、印刷物の文字量を通して伝わってくるのです。
技術革新と社会の移り変わり
新しい技術が誕生し、古い技術が役目を終えていく過程も、Nグラムのグラフは如実に語ってくれます。
たとえば、「carriage(馬車)」と「automobile(自動車)」という二つの言葉を同じグラフに並べて比較してみると、非常にドラマチックな交代劇を見ることができます。19世紀から20世紀初頭にかけて圧倒的な出現頻度を誇っていた馬車は、1910年代から1920年代を境にして急速に下落していきます。一方で、それと入れ替わるように自動車という単語が急上昇を始めます。技術の主役が交代した瞬間が、グラフの交差点として鮮明に記録されているのです。
コンピューターの登場以降も同様で、「radio(ラジオ)」「television(テレビ)」「computer(コンピューター)」「internet(インターネット)」と順を追って比較していくと、情報技術の波がどのように人々の暮らしと意識を塗り替えていったのかが手に取るように分かります。
人々の価値観や思想の移り変わり
物や技術の名称だけでなく、人々の内面的な関心や道徳観、精神世界の変化も追跡することができます。
西洋の書籍において、「duty(義務・本分)」や「virtue(美徳)」といった道徳的な規範を表す単語は、19世紀から20世紀にかけて全体として右肩下がりの傾向を見せています。一方で、「freedom(自由)」や「individual(個人)」、さらには「psychology(心理学)」といった個人の自由や内面、自我に関する単語は20世紀を通じて大きく上昇していきました。社会が共同体優先の価値観から、個人の幸福や自己実現を重視する社会へとシフトしていった歴史的な潮流が、言葉の使用頻度にも静かに反映されているのです。
文化を科学的に測定する新しい学問「カルチャロミクス」
このように、文字の電子データとNグラム分析を活用して、人間の文化や言語、歴史のトレンドを定量的に研究する新しい分野は「カルチャロミクス(Culturomics)」と呼ばれています。2010年にハーバード大学の研究者チームが科学雑誌『Science』に発表した論文をきっかけに、世界的な注目を集めました。
これまで、文化や歴史の研究といえば、文学者の直感や歴史学者の主観的な解釈に頼らざるを得ない部分が多くありました。しかし、何百万冊という書籍の全テキストを対象に統計的な処理を行うことで、「この時代にこの概念がどれくらい普及していたか」を客観的な数字やグラフとして提示できるようになったのです。カルチャロミクスは、人文科学の深い洞察に自然科学のデータ分析手法を組み合わせた画期的なアプローチとして、現在も様々な研究に応用されています。
Nグラム分析を楽しむ際に知っておきたい注意点
非常に便利で刺激的なNグラム分析ですが、グラフの形をそのまま鵜呑みにしてしまうと、誤った結論を導き出してしまう危険性もあります。データを読み解く際には、いくつかの特性や落とし穴を頭に入れておくことが大切です。
書籍の性質によるバイアス(偏り)
Google Booksに収録されている文章は、あくまで「印刷された本」のテキストです。本になる文章は、新聞記事や雑誌、あるいは街中の日常会話とは異なり、出版社の編集者の校閲を経た、比較的フォーマルで専門的な言葉遣いが多くなります。
したがって、庶民の間で日常的に交わされていたスラングや俗語、口語の流行語などは、社会で爆発的に流行していたとしても、本の中に文字として現れるまでに何年もタイムラグが生じることがあります。また、20世紀後半になると学術論文や専門書の出版数が急増したため、学術用語全体の出現比率が底上げされ、一般的な日常語の割合が相対的に下がって見えるといった出版傾向の偏りも存在します。
文字認識のエラー(OCRの誤読)
古い本をスキャンして文字データに変換する際、文字を自動認識する技術(OCR)が使われますが、紙の劣化によるシミや文字のかすれ、古い活字の独特な字体によって、誤った文字として読み取られてしまうケースがあります。
有名な例として、古い英語の印刷物では小文字の「s」が「f」に非常によく似た細長い書体で印刷されていたため、コンピューターがすべて「f」として誤読してしまい、本来存在しない綴りの単語が大量に出現しているように集計されてしまう現象がありました。近年の技術向上で修正が進んでいますが、極端に古い時代のデータを見る際には注意が必要です。
言葉の多義性と文脈の見落とし
Nグラムは機械的に文字や単語の並びを数え上げる仕組みであるため、「その言葉がどのような文脈や感情で使われたのか」までは区別してくれません。
たとえば、「apple」という単語を検索した場合、それが果物のリンゴを指しているのか、それとも巨大IT企業のアップル社を指しているのかは、単語単体では判断できません。称賛の意味で使われているのか、批判の文脈で頻出しているのかも、グラフの数値だけでは分かりません。グラフの急激な変化に気づいたときは、数字だけで早合点せず、実際にその年に出版された代表的な本を開いて文脈を確認する姿勢が大切です。
まとめ
言葉の並びを数える「Nグラム」という考え方と、数千万冊もの本をデータ化した「Google Books」の組み合わせは、私たちが歴史や文化を見つめる視点を大きく変えてくれました。
画面に現れる一本の折れ線グラフには、かつて生きていた無数の人々が何を恐れ、何に憧れ、どんな生活を送っていたのかという「時代の空気」が凝縮されています。遠い過去の出来事も、言葉の移り変わりという身近な手がかりを通して眺めてみると、驚くほど生々しく現代の私たちとつながっていることが実感できます。
パソコンやスマートフォンから「Google Books Ngram Viewer」にアクセスすれば、誰でも今日から過去の言葉の探検を始めることができます。気になった単語や、身の回りの歴史的なキーワードをいくつか打ち込んで、その背後に眠る時代のドラマをぜひご自身の手で掘り起こしてみてください。
参考リスト
- Google Books Ngram Viewer 公式サイト
- Science 誌掲載論文:Quantitative Analysis of Culture Using Millions of Digitized Books(カルチャロミクスに関する原著論文)
- Google ブックス サービス概要ページ