はじめに
スーパーのポイントカードを出すと、なぜか自分好みのクーポンが届くことがあります。その裏側では、たくさんのお客さんを「似た買い方をする人」ごとにまとめる計算が動いています。その代表的な方法が、今回取り上げるk平均法(クラスタリング)です。名前は難しそうですが、考え方は「近いもの同士を集めて、真ん中を決め直す」をくり返すだけのシンプルなものです。
👇 本記事でわかる3つの重要ポイント 👇
- 【テーマ1】k平均法がグループを決める4つの手順
- 【テーマ2】スーパーが客層分析に使うデータと分け方の実例
- 【テーマ3】うまく分けるためのコツと見落としがちな弱点
数式は使わず、身近なたとえ話で説明します。データ分析の入り口として、ぜひ最後まで読んでみてください。
k平均法(クラスタリング)とは?似たもの同士を自動で集める方法
k平均法とは、たくさんのデータを、あらかじめ決めた「k個」のグループに自動で分ける計算方法です。英語では「k-means法(ケー・ミーンズ法)」と呼ばれ、グループ分けの方法の中で最も基本的なものとして広く使われています。
ここでいう「クラスタリング」とは、データの中から似たもの同士を集めてかたまり(クラスタ)を作ることです。AI開発のエクサウィザーズの解説では、k平均法は「最もスタンダードなクラスタリング手法」と紹介されています。
「正解」を教えずに分ける教師なし学習
k平均法は、機械学習の中でも「教師なし学習」と呼ばれる種類に入ります。教師なし学習とは、「この人は節約派」といった正解のラベルを人間が用意しなくても、コンピューターがデータの形から自分でまとまりを見つける方法です。
スーパーの場合、何十万人ものお客さん一人ひとりに「あなたは〇〇タイプ」と人の手で名札を付けるのは不可能です。正解なしでグループを見つけられる点が、客層分析と相性のよい理由です。
60年以上前に生まれた歴史ある方法
k平均法は、AIブームより前から使われている古い方法です。英語版ウィキペディアによると、「k-means」という名前は1967年にジェームズ・マックイーンが初めて使いました。考え方そのものは1950年代にポーランドの数学者フーゴ・シュタインハウスが示していたとされます。
また、今の標準的な計算手順は、ベル研究所のスチュアート・ロイドが1957年に考えたもので、論文として発表されたのは1982年でした。そのため、この手順は「ロイドのアルゴリズム(計算手順)」とも呼ばれます。もともとは通信の信号を効率よく扱う技術として考えられたものが、今では顧客分析に役立てられているのです。
k平均法の仕組み:4つのステップでグループが決まる
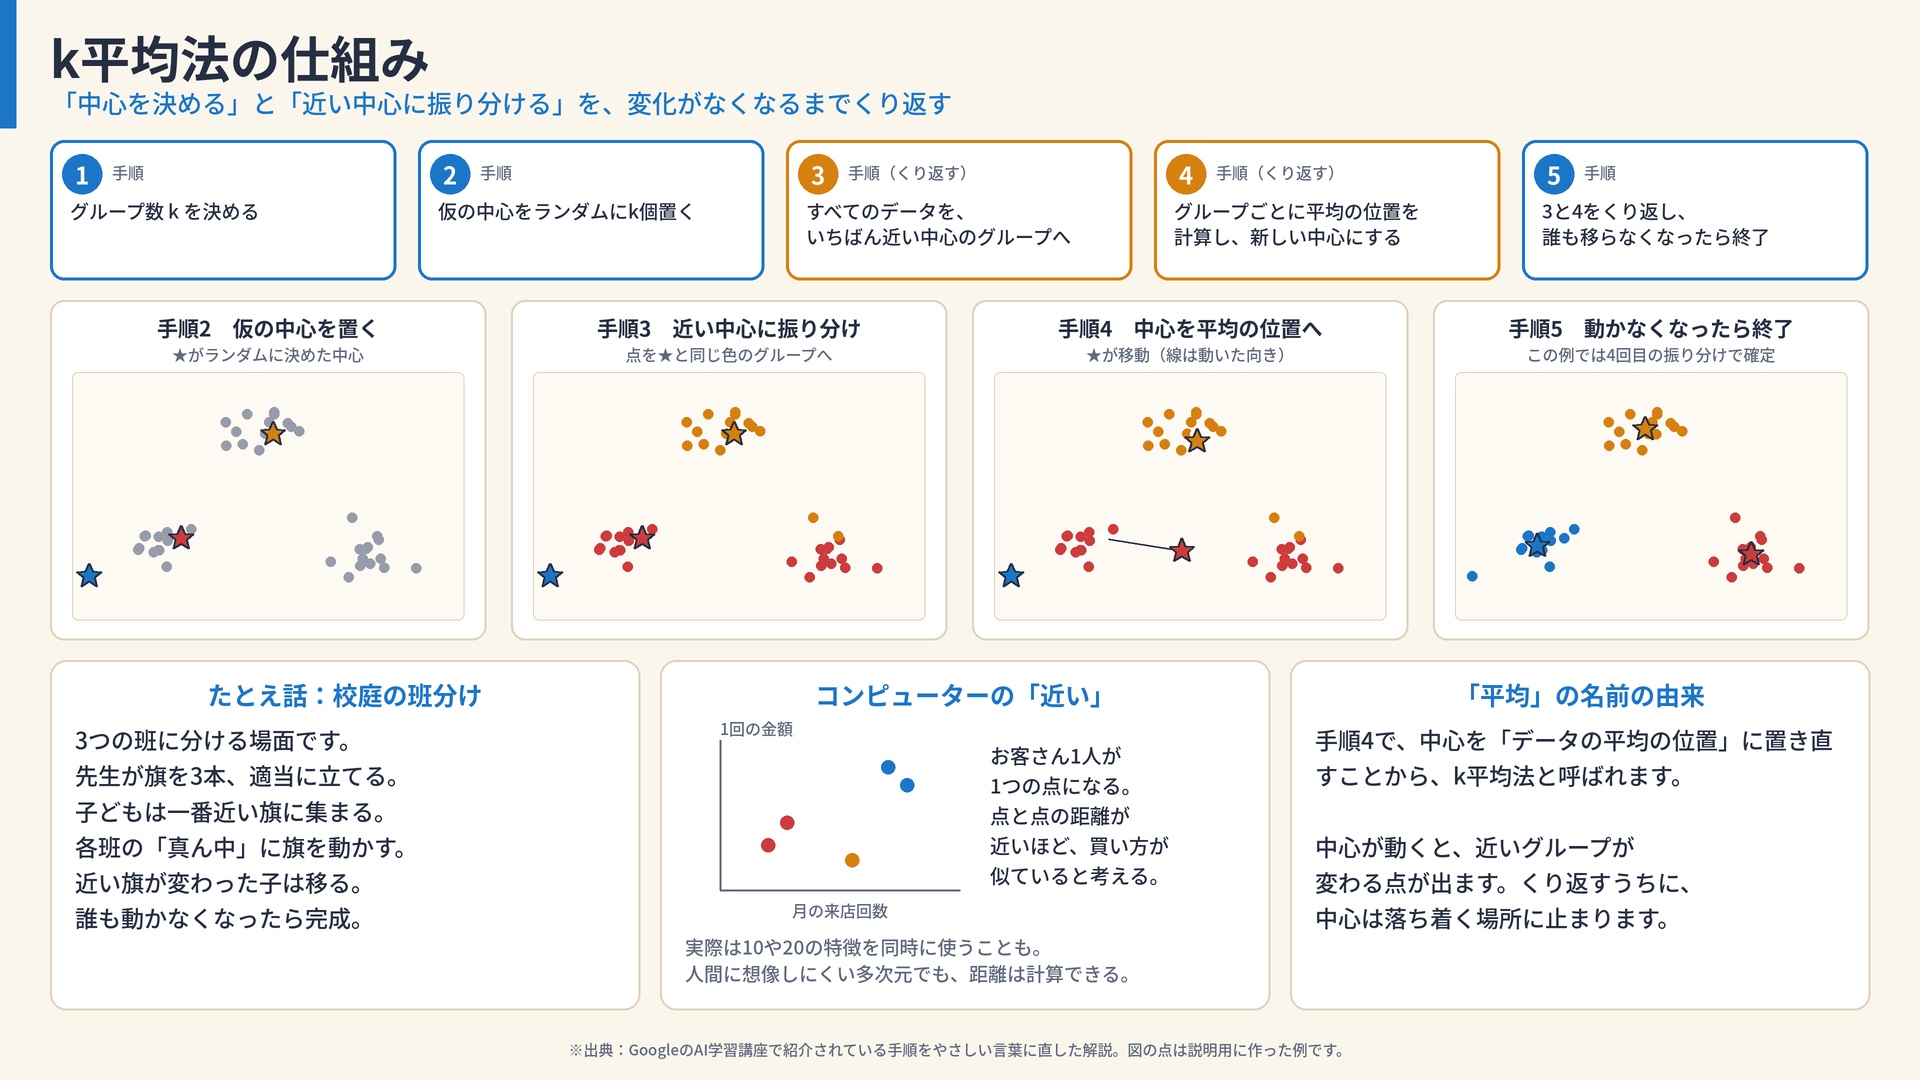
k平均法は「グループの中心を決める」と「近い中心に振り分ける」を、変化がなくなるまでくり返すだけで答えを出します。GoogleのAI学習講座で紹介されている手順を、やさしい言葉に直すと次のとおりです。
- いくつのグループに分けるか(k)を決める
- グループの中心(重心)の仮の位置を、ランダムにk個決める
- すべてのデータを、いちばん近い中心のグループに入れる
- グループごとにデータの平均の位置を計算し、そこを新しい中心にする
- 3と4をくり返し、どのデータもグループを移らなくなったら終了
「k平均法」の「平均」は、手順4で中心を平均の位置に置き直すところから来ています。中心が動くと、近いグループが変わるデータが出てきます。それを何度かくり返すうちに、中心がだんだん落ち着く場所に止まるのです。
たとえ話:校庭に集まった子どもたちの班分け
校庭に散らばった子どもたちを、3つの班に分ける場面を想像してください。まず先生が3本の旗を適当な場所に立て、子どもたちは一番近い旗に集まります。
次に、各班の子どもたちが立っている場所のちょうど真ん中に旗を動かします。すると、別の旗の方が近くなった子どもは、そちらの班へ移ります。これをくり返し、誰も移動しなくなったら班分けの完成です。k平均法がしているのは、まさにこの作業です。
コンピューターにとっての「近い」とは
校庭なら「近い」は歩く距離ですが、お客さんの場合は買い物の特徴の近さです。たとえば「月の来店回数」と「1回の買い物金額」を縦と横の軸にしたグラフを作ると、お客さん一人ひとりが1つの点になります。点と点の距離が近いほど、買い方が似ていると考えるわけです。
実際の分析では、2つどころか10や20の特徴を同時に使うこともあります。人間には想像しにくい多次元の空間でも、コンピューターは同じように距離を計算できます。
スーパーはどんなデータで客層を分けるのか
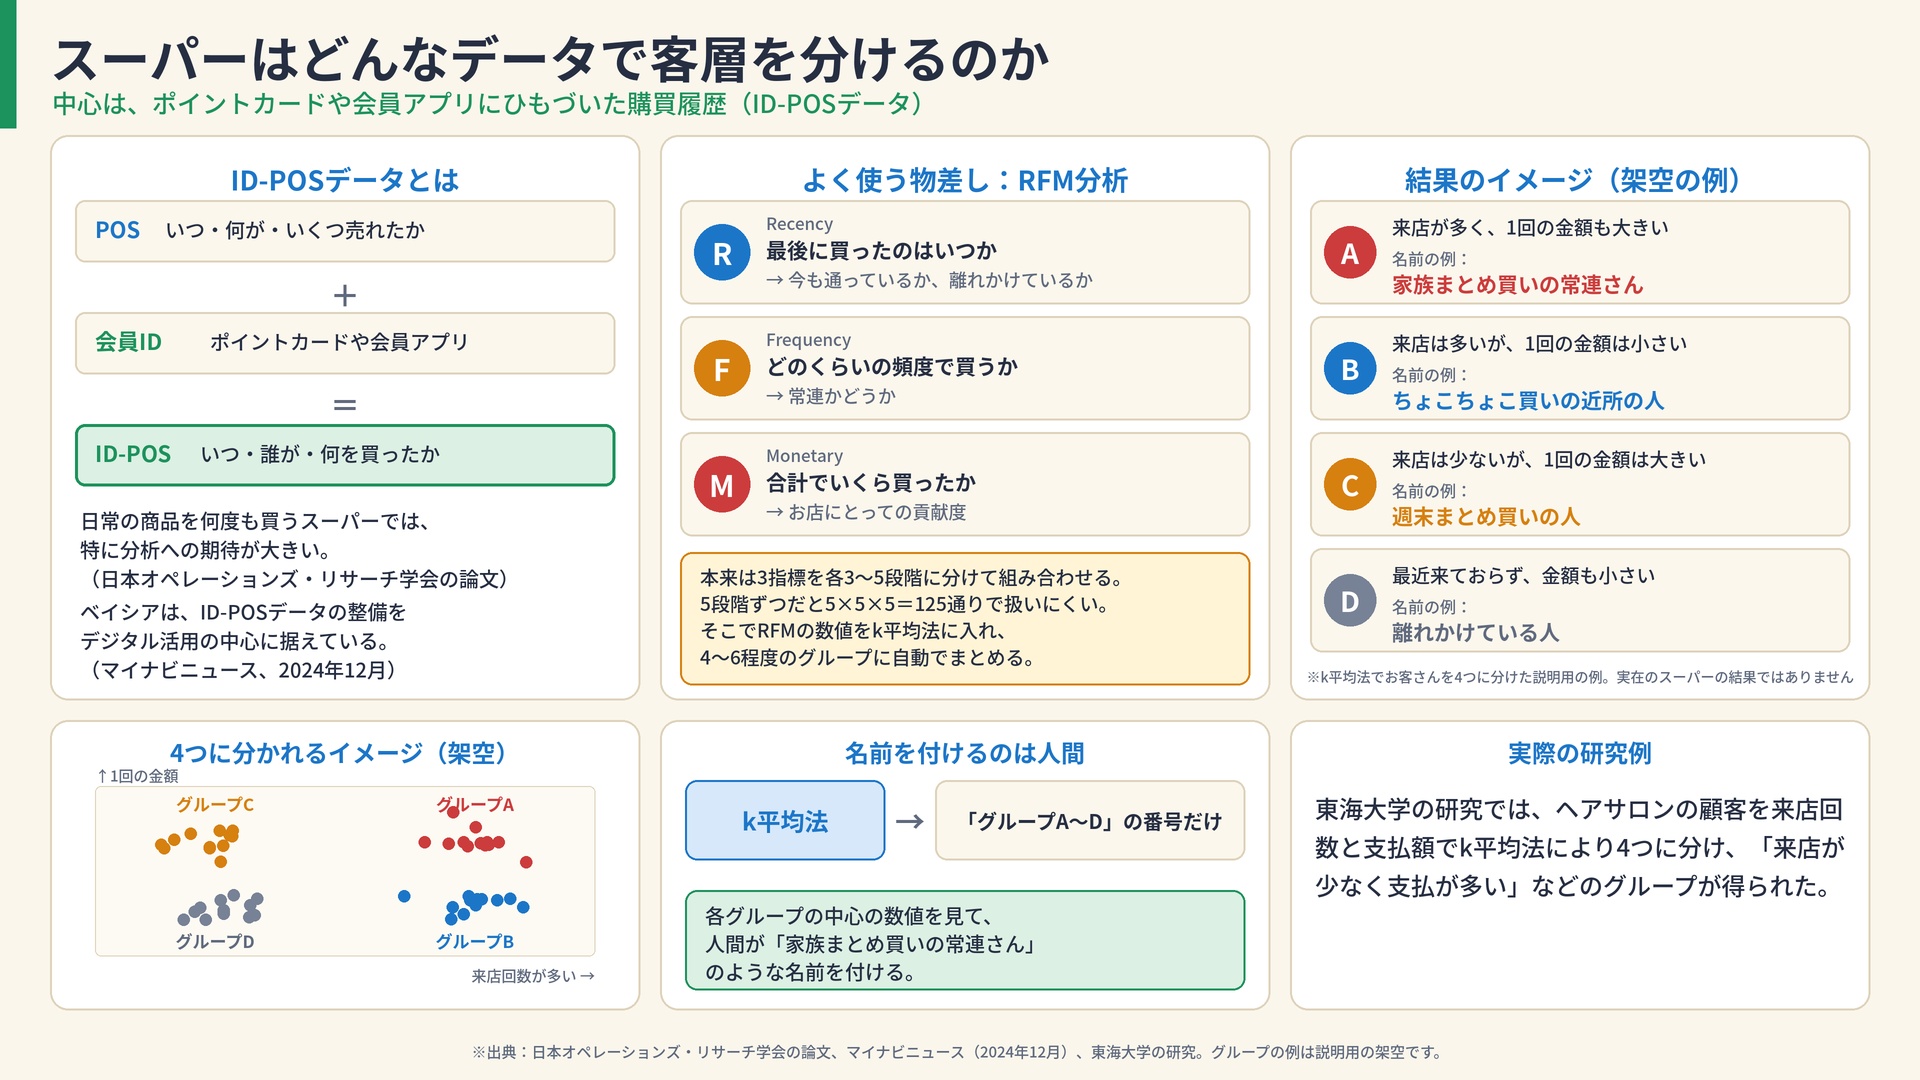
スーパーが客層分析に使う中心的なデータは、ポイントカードや会員アプリにひもづいた購買履歴です。これを「ID-POSデータ」と呼びます。
ID-POSデータとは
POS(ポス)とは、レジで「いつ、何が、いくつ売れたか」を記録する仕組みのことです。そこに会員IDが加わったものがID-POSデータで、「いつ、誰が、何を買ったか」までわかります。日本オペレーションズ・リサーチ学会の論文では、ポイントカードの普及でID-POSデータの活用が広がり、日常的な商品を何度も買うスーパーでは特に分析への期待が大きいと述べられています。
実際の企業の取り組みとして、関東甲信越や東海地方で大型スーパーを展開するベイシアでは、ID-POSデータの整備をデジタル活用の中心に据えていると、マイナビニュースが2024年12月に報じています。同じ記事では、スーパーは家族のための食材をまとめて買う「代理購入」が多く、コンビニとは買い方が違う点も紹介されています。
よく使われる物差し「RFM分析」
お客さんをグループ分けするとき、よく使われる物差しが「RFM分析」の3つの指標です。
| 指標 | 意味 | わかること |
|---|---|---|
| R(Recency) | 最後に買ったのはいつか | 今も通っているか、離れかけているか |
| F(Frequency) | どのくらいの頻度で買うか | 常連かどうか |
| M(Monetary) | 合計でいくら買ったか | お店にとっての貢献度 |
RFM分析は、本来は各指標を3〜5段階のランクに分けて組み合わせる方法です。ただ、3つの指標を5段階ずつにすると125通りにもなり、扱いにくくなります。そこで、RFMの数値をk平均法に入れて、似た人同士を4〜6程度のグループに自動でまとめるという使い方がされます。
グループ分けの結果のイメージ
次の表は、k平均法でお客さんを4つに分けたときの説明用の架空の例です。実在するスーパーの分析結果ではありません。
| グループ | 特徴 | 考えられる名前 |
|---|---|---|
| A | 来店が多く、1回の金額も大きい | 家族まとめ買いの常連さん |
| B | 来店は多いが、1回の金額は小さい | ちょこちょこ買いの近所の人 |
| C | 来店は少ないが、1回の金額は大きい | 週末まとめ買いの人 |
| D | 最近来ておらず、金額も小さい | 離れかけている人 |
大事なのは、k平均法が出すのは「グループA〜D」という番号だけだという点です。「家族まとめ買いの常連さん」といった名前は、各グループの中心の数値を見て人間が付けます。実際に東海大学の研究では、ヘアサロンの顧客を来店回数と支払額でk平均法により4つに分け、「来店が少なく支払が多い」などのグループが得られています。
うまくグループ分けするための3つのコツ
k平均法は手順こそ単純ですが、事前の準備と設定しだいで結果が大きく変わります。特に大切なのが次の3つです。
コツ1:数字の大きさをそろえる(標準化)
k平均法は距離で近さを測るため、数字の幅が大きい項目ほど結果を強く左右します。たとえば「買い物金額(数千〜数万円)」と「来店回数(月に数回)」をそのまま使うと、金額の差ばかりが距離に効いてしまいます。
そこで、各項目を「平均0、ばらつき1」にそろえる標準化という下準備をしてから計算するのが一般的です。データ分析サービスのMetricGateも、単位の違う項目でk平均法を使う前には標準化をするよう勧めています。
コツ2:グループの数kを根拠をもって決める
k平均法では、いくつに分けるかを人間が先に決めなければなりません。大阪産業技術研究所の技術資料では、その目安を探す方法として「エルボー法」と「シルエット係数」が紹介されています。
- エルボー法:グループ数を1、2、3と増やしながら、各データと中心のずれの合計をグラフにします。ずれの減り方が急に緩やかになる「ひじ(エルボー)」のように曲がった点を、ちょうどよい数と考えます。
- シルエット係数:各データが自分のグループにどれだけしっくり収まり、隣のグループからどれだけ離れているかを点数にしたものです。-1から1の範囲で、1に近いほどきれいに分かれていると判断します。
ただし、数値だけで決めるとは限りません。スーパーの現場では、「チラシやクーポンを何種類まで作り分けられるか」といった実務の都合も考えて、扱いやすい数に落ち着かせることがよくあります。
コツ3:最初の中心の置き方を工夫する
手順2で中心をランダムに置くため、スタート地点によって結果が変わることがあります。Googleの講座でも、実行するたびに結果が大きく変わりうるので、何度か実行して最も良い結果を選ぶ対策が示されています。
この弱点を和らげる工夫が、2007年にアーサーとヴァシルヴィツキーが発表した「k-means++(ケー・ミーンズ・プラスプラス)」です。最初の中心どうしがなるべく離れるように置く方法で、Pythonの代表的な機械学習ライブラリ「scikit-learn」では、これが標準の設定になっています。
k平均法の弱点と使うときの注意点
k平均法は手軽で速い一方、どんなデータでもうまく分けられる万能の方法ではありません。主な弱点は次のとおりです。
- 丸いかたまりを前提にしている:scikit-learnの説明によると、細長い形や不規則な形のまとまりはうまく扱えません。
- 極端な値に引っ張られる:中心を平均で決めるため、1人で何百万円も買う法人客のような外れ値があると、中心がずれてしまいます。
- 本当の最適解とは限らない:計算は必ず止まりますが、止まった場所が「その近くでの最良」にすぎない場合があります。
- まとまりがなくても無理に分ける:データにはっきりした構造がなくても、指定したk個に必ず分けてしまいます。
- 数値以外は苦手:「よく買う売り場」のような数字でない情報は、そのままでは距離を測れません。
こうした弱点を補うため、外れ値に強い「k-medoids法」や、形の自由なまとまりを見つける「DBSCAN」など、別の方法が使い分けられています。日本オペレーションズ・リサーチ学会の論文には、スーパーの大規模なID付きPOSデータを「自己組織化マップ(SOM)」という別のクラスタリング手法で分析した研究もあります。
また、購買データは個人の生活がわかる情報でもあります。お店がデータを分析に使うときは、利用目的の説明や個人情報の適切な扱いが前提になります。
グループ分けの結果はどう生かされるのか
グループ分けは、それ自体がゴールではなく、お客さんに合った働きかけを考えるための土台です。RFM分析の解説でも、優良な顧客には特典を、離れそうな顧客には再び来てもらう働きかけを、という使い分けが例として挙げられています。
先ほどの架空の例に当てはめると、次のような考え方ができます。
- 家族まとめ買いの常連さん:大容量パックや週末の特売の案内
- ちょこちょこ買いの近所の人:お惣菜や夕方の値引き情報
- 離れかけている人:久しぶりの来店で使えるクーポン
お客さんの買い方は季節や生活の変化で移り変わるため、一度分けたら終わりではありません。定期的にデータを入れ直して分け直すことで、グループの変化を追いかけることができます。
よくある質問
k平均法の「k」とは何ですか?
kは「いくつのグループに分けるか」という数のことです。k=3なら3つのグループに分けます。このkは計算の前に人間が決める必要があり、エルボー法やシルエット係数が目安として使われます。
k平均法とRFM分析は何が違うのですか?
RFM分析は「最終購入日・購入頻度・購入金額」という3つの物差しで顧客を評価する考え方です。k平均法は、物差しの数値をもとに似た人同士を自動で集める計算方法です。両者は対立するものではなく、RFMの数値をk平均法でグループ分けするように組み合わせて使えます。
同じデータで計算しても結果が変わることはありますか?
あります。最初の中心をランダムに置くため、スタート地点によって最終的なグループが変わることがあります。そのため、何回か実行して最もまとまりの良い結果を選んだり、k-means++で初期位置を工夫したりします。
個人でもk平均法を試せますか?
試せます。Pythonの無料ライブラリ「scikit-learn」には、k平均法を手軽に使える機能が用意されています。ブラウザ上でPythonを動かせるGoogle Colabなどを使えば、パソコンに特別な準備をしなくても体験できます。
まとめ
k平均法は、「中心を決めて、近いものを集め、中心を平均の位置に置き直す」をくり返すだけで、似たもの同士のグループを自動で作る方法です。スーパーでは、ポイントカードにひもづいたID-POSデータや、RFM分析の3つの指標を材料にして、客層をいくつかのタイプに分けるために役立てられています。
ただし、グループ数を人間が決めること、数字の大きさをそろえる下準備が必要なこと、外れ値や丸くないまとまりが苦手なことなど、知っておきたい注意点もあります。数字のグループに意味のある名前を付け、施策に結びつけるのは、最後は人間の役目です。
次にスーパーのアプリやレシートでクーポンを受け取ったら、「自分はどんなグループに入っているのだろう」と想像してみてください。興味がわいたら、Google Colabとscikit-learnで、身近な数字をk平均法でグループ分けしてみるのもおすすめです。
参考リスト
- K 平均法クラスタリングとは(Google for Developers)
- クラスタリングとは(エクサウィザーズ)
- k-means clustering(Wikipedia)
- Clustering(scikit-learn ユーザーガイド)
- k平均法(k-means法)についての技術資料(大阪産業技術研究所)
- 商品の潜在的類似性に基づくクラスタリング手法の提案(日本オペレーションズ・リサーチ学会)
- 食品スーパーの多様性と顧客購買行動との関係分析(日本オペレーションズ・リサーチ学会)
- ベイシアのID-POSデータ活用に関する記事(マイナビニュース TECH+)
- 顧客の来店特性と店舗運営に関する一考察(東海大学)
- RFM分析による顧客分類(CodeZine)
- RFM分析とは(一創)
- K-Means実行後のクラスタープロファイルの解釈法(MetricGate)