はじめに
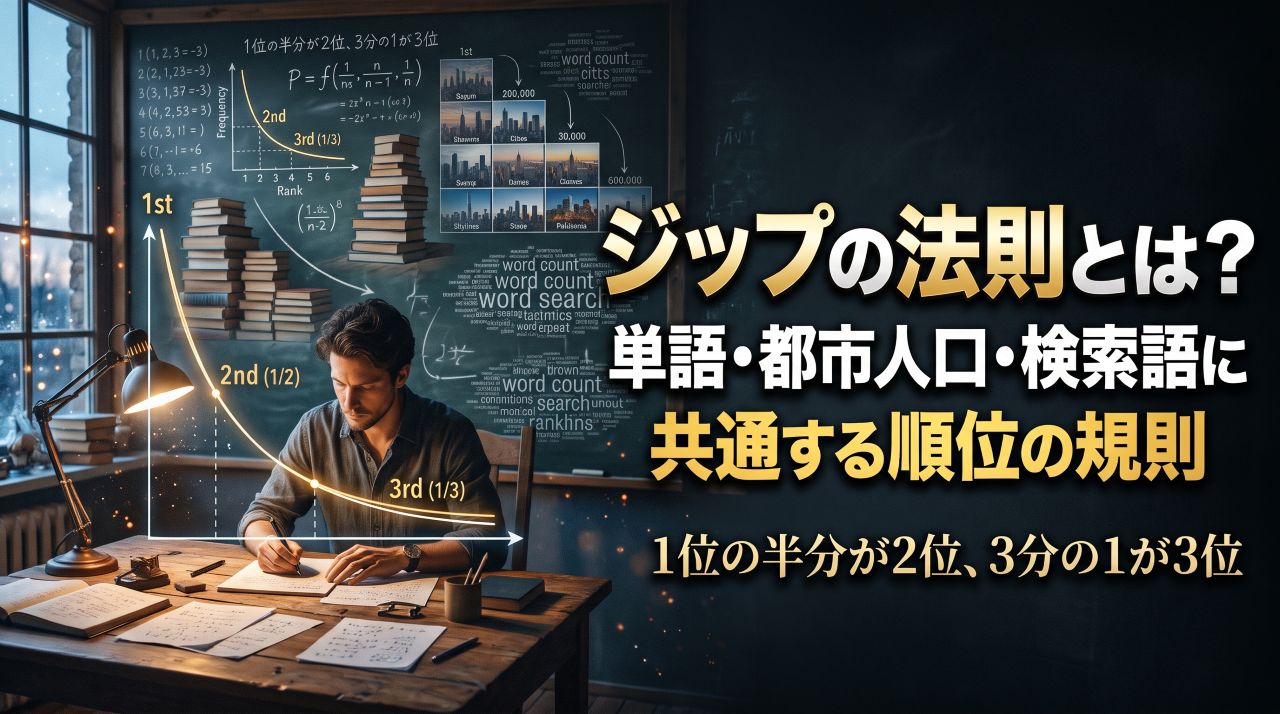
英語の文章でいちばんよく使われる単語は、2番目の単語のおよそ2倍、3番目の単語のおよそ3倍も登場します。しかも、この「1位の半分が2位、3分の1が3位」という並び方は、言葉の世界だけでなく、都市の人口や検索エンジンに打ち込まれる言葉にも現れます。まったく関係がなさそうなものに共通するこの不思議な規則が、ジップの法則です。
👇 本記事でわかる3つの重要ポイント 👇
- 【テーマ1】ジップの法則の基本と身近な実例
- 【テーマ2】単語・都市・検索語で同じ形が現れる仕組みの有力説
- 【テーマ3】ジップの法則の意外な活かし方と注意点
数式はほとんど使わず、具体的な数字とたとえ話で説明します。読み終えるころには、身の回りの「ランキング」が少し違って見えてくるはずです。
ジップの法則とは?「1位の半分が2位」というシンプルな規則
ジップの法則とは、ものごとを多い順に並べたとき、n番目の量が1番目のおよそn分の1になるという経験則(実際のデータから見つかった決まりごと)です。順位と量が「反比例」の関係になる、と言い換えることもできます。
名前の由来は、アメリカの言語学者ジョージ・キングズリー・ジップです。ジップは1930年代から単語の使われ方を数え続け、1949年に著書『人間の行動と最小努力の原理(Human Behavior and the Principle of Least Effort)』で、この規則を人間の行動全般に広げて論じました。
ただし、発見したのはジップが最初ではありません。英語版ウィキペディアのまとめによると、都市人口については1913年にドイツの物理学者フェリックス・アウエルバッハが、単語については1916年にフランスの速記者ジャン=バティスト・エストゥが、すでに似た関係に気づいていました。ジップ自身も「自分が最初だ」とは主張していなかったとされています。
考え方をつかむために、1位が1,000回登場するとした場合の「理想の数字」を計算すると、次のようになります。
| 順位 | 1位との比率 | 理想的な回数(計算上) |
|---|---|---|
| 1位 | 1 | 1,000回 |
| 2位 | 2分の1 | 500回 |
| 3位 | 3分の1 | 約333回 |
| 4位 | 4分の1 | 250回 |
| 10位 | 10分の1 | 100回 |
| 100位 | 100分の1 | 10回 |
上位のごく一部が飛び抜けて多く、下位には少しずつしか登場しないものがずらりと続く形です。この形をグラフにすると、右下へ長い尾を引くように見えることから「ロングテール(長い尾)」とも呼ばれます。
また、順位と回数をそれぞれ対数(桁数のような目盛り)でとったグラフに描くと、点がほぼ一直線に並びます。この性質を持つ関係を、専門的にはべき乗則と呼びます。ジップの法則は、べき乗則の中でも「傾きがほぼマイナス1」という特別なケースにあたります。
単語の出現頻度に見るジップの法則
ジップの法則がもっともきれいに現れるのが、文章の中の単語の出現回数です。言語や書き手が違っても、おおむね同じ形になることが知られています。
有名な例が、100万語あまりのアメリカ英語の文章を集めた「ブラウン・コーパス」(コーパスは研究用の大規模な文章データ)です。英語版ウィキペディアによると、1位の「the」は69,971回で全体の約7%、2位の「of」は36,411回で約3.5%と、ほぼちょうど半分になっています。3位の「and」は28,852回で、理想の約23,300回よりやや多いものの、おおむね近い数字です。
さらに驚くのは、ごく少数の単語が文章の大部分を占めていることです。同じブラウン・コーパスでは、わずか135種類の単語のくり返しで、全体の半分がうまってしまうと報告されています。裏を返せば、残り半分には数万種類もの単語が少しずつ登場しているわけです。
この傾向は英語に限りません。ジップ自身もアメリカの新聞、古代ローマの劇作家プラウトゥスのラテン語、中国語の文章などを調べ、どれも同じ規則に従うことを示しました。人工的に作られた言語であるエスペラントやトキポナでも、ジップの法則が成り立つことが確かめられています。
日本語の研究でも、単語の出現頻度の順位と大きさの関係は、言語によらない文章の普遍的な特徴と考えられています。大学の授業レポートでは、落語の語りを数えてこの規則を確かめる試みも紹介されています。
ただし、完全にぴったりというわけではありません。上位や最下位の端の部分では理想の線からずれることが多く、言語や話題、書き手によってもずれ方が変わります。3万冊の英語の文章を調べた研究では、ジップの法則によく当てはまったのは約15%で、定義を少しゆるめても50%近くにとどまったと報告されています。
都市の人口とジップの法則
都市の人口もジップの法則の代表例ですが、国や時代によって当てはまり方が大きく変わります。「いつでもどこでも成り立つ」とは言えない点が、単語との大きな違いです。
わかりやすいのがアメリカの例です。コーネル大学の授業ブログによると、2010年の国勢調査で1位のニューヨーク市は約820万人、2位のロサンゼルスは約390万人、3位のシカゴは約270万人でした。2位は1位のほぼ半分、3位はほぼ3分の1で、4位ヒューストン(約210万人)、5位フィラデルフィア(約150万人)も、おおむね4分の1から5分の1の範囲に収まっています。
一方、日本の都市は少し事情が異なります。國仲寛人氏と松下貢氏の研究(2008年)は、戦後の国勢調査データを分析し、日本の都市の順位と人口の関係が「上位」と「それ以下」の2つの部分に分かれることを示しました。さらに、上位部分でジップの法則が成り立っていたのは限られた期間だけだったとしています。
その原因として挙げられたのが、市町村合併です。研究によると、昭和の大合併と平成の大合併によってジップの法則が崩れ、昭和の大合併のあとは中規模都市の人口が増えたことで、いったん回復したと報告されています。行政が「どこまでを1つの市とするか」を決める仕組みが、統計の形そのものを変えてしまうわけです。
まとまりの単位も重要です。2012年に科学誌に発表された研究では、世界の大都市をまとめて並べてもジップの法則は現れない一方、ナイジェリアのように1つの国としてまとまって発展してきた地域では、ほぼ理想に近い形が見られたとしています。人々が自由に行き来できる、ひとつながりの社会であることが前提になっているようです。
なお、近年の実証研究や理論研究の中には、都市の人口にジップの法則を当てはめること自体に疑問を投げかけるものもあります。都市の例は「大まかな傾向」として楽しむのがよさそうです。
検索ワードにも現れるジップの法則
インターネットで検索される言葉の回数も、ジップの法則に近い形になります。ごく一部の人気ワードに検索が集中し、残りの大多数はめったに検索されないという並び方です。
2006年には、科学サイト「Fourmilab」を運営するジョン・ウォーカー氏が、公開されたAOLの検索記録を単語ごとに数えて分析しました。その結果、検索ワードという独特の言葉づかいでも、出現回数がべき乗則でよく近似できることを示しています。
ウェブの使いやすさ研究で知られるニールセン・ノーマン・グループの記事では、あるサイトにたどり着くために使われた検索の言葉が、合計で110,399種類にものぼったと紹介されています。上位の数個の言葉だけに注目して対策することは、全体から見ると一部しか見ていないことになる、というのが記事の指摘です。
検索エンジンの仕組みにもこの性質が関係しています。カナダのウォータールー大学で公開されている検索ログ研究の資料でも、検索エンジンへの問い合わせはべき乗分布に従い、均等とはほど遠いと述べられています。よく検索される言葉はあらかじめ結果を用意しておき、まれな言葉はその都度計算する、といった工夫ができるのはこのためです。
ちなみに、検索の「言葉の長さ」の分布を調べた研究もあります。2008年の国際会議で発表された研究では、2語の検索がもっとも多く、長い検索ほど急速に少なくなる形をしていて、単語の出現頻度よりもずっと急な傾きになると報告されています。
なぜ同じ規則が現れるのか?有力な3つの説
結論から言うと、ジップの法則が現れる理由は、まだ完全には解明されていません。数学者のテレンス・タオ氏も2012年の論文で、数学者はこの法則がなぜ生じ、なぜ普遍的なのかについて十分に納得のいく説明を持っていない、という趣旨を述べています。そのうえで、有力な説を3つ紹介します。
説1:最小努力の原理
ジップ自身が唱えたのが「最小努力の原理」です。話し手にとっては、どんな意味にも使える万能の単語が1つあれば楽です。しかし聞き手にとっては、1語ごとに意味が決まっていたほうが楽です。この両者の「楽をしたい」という力がつり合った結果、よく使う少数の言葉と、たまにしか使わない多数の言葉という形に落ち着く、という考え方です。
説2:「持てる者がさらに持つ」成長の仕組み
大きいものほど、さらに大きく育ちやすいという仕組みも、ジップの法則を生むと考えられています。人口の多い都市ほど人を引きつけ、よく使われる単語ほどさらに使われる、という流れです。経済学者のハーバート・サイモンは、この考え方を都市にあてはめました。また、経済学者グザヴィエ・ガベ氏は1999年の論文で、都市の規模に関係なく同じ割合で成長・縮小がくり返されると、結果としてジップの法則に近い形になることを示しています。
説3:でたらめでも現れるという説
意外なことに、意味のない文章でも似た形が現れます。1957年に心理学者ジョージ・ミラーが指摘し、1992年には生命情報科学者のウェンティアン・リー氏が、文字と空白をでたらめに並べただけの文章でも、単語の出現頻度がジップの法則に近い形になることを示しました。サルがタイプライターを適当に打っても同じ形になる、というたとえで知られる考え方です。
この説が正しければ、ジップの法則は「人間らしさ」の証拠というより、ものを順位で並べたときに自然と生まれる性質の一部ということになります。どの説が中心なのかは、対象によって違う可能性もあり、今も研究が続いています。
ジップの法則を暮らしや仕事に活かすヒント
ジップの法則を知っておくと、「どこに力を入れれば効率がよいか」を考える手がかりになります。ただし、厳密な法則ではなく大まかな目安として使うことが大切です。
- 外国語の学習:上位のよく使う単語ほど出番が多いため、まず頻度の高い単語から覚えると、少ない努力で読める範囲が大きく広がります。
- ブログやウェブサイト運営:人気キーワードは競争が激しい一方、検索回数の少ない言葉が無数にあり、合計すると大きな量になります。具体的で長めの言葉を意識した記事づくりが、ロングテールを拾う近道です。
- お店や在庫の管理:売れ筋の少数の商品と、たまにしか売れない多数の商品という形を意識すると、並べ方や仕入れの考え方を整理しやすくなります。
- 文章の分析:単語の頻度の並び方は書き手ごとに特徴が出やすく、変化も小さいため、作者を推定する研究にも使われています。
応用はさらに広がっています。解読されていない15世紀の古文書「ヴォイニッチ手稿」の文字のかたまりがジップの法則を満たすことから、でたらめの作り物ではなく、何らかの言語や暗号である可能性が高いと考えられています。地球外からの信号に言語らしさがあるかを調べる手がかりとして使う案も出ています。
よくある質問
ジップの法則とパレートの法則(80対20の法則)は同じものですか?
どちらも「少数が全体の多くを占める」偏りを表す点で深く関係しています。英語版ウィキペディアでは、ジップ分布は「離散的なパレート分布」とも呼ばれると説明されています。ジップの法則は順位と量の関係に注目し、パレートの法則は上位がどれだけの割合を占めるかに注目する、という見方の違いだと考えるとわかりやすいでしょう。
日本語の文章でもジップの法則は成り立ちますか?
はい、おおむね成り立つと考えられています。単語の出現頻度の順位と大きさの関係は、言語によらない文章の共通した特徴とされています。ただし、どこで単語を区切るかによって結果が変わるため、きれいな直線になるかどうかは数え方にも左右されます。
都市の人口は、どの国でもジップの法則に従いますか?
いいえ、国や時代によって当てはまり方が違います。日本では市町村合併の影響で法則が崩れた時期があることが研究で示されており、世界の都市をまとめて並べた場合にも当てはまりにくいと報告されています。
ジップの法則は何の役に立つのですか?
検索エンジンの効率化、データ圧縮、外国語の学習計画、作者の推定、古文書の分析など、幅広い分野で使われています。「上位に集中しつつ、下位も無視できない量がある」という見取り図を持てることが、いちばんの利点です。
まとめ
ジップの法則は、「1位の半分が2位、3分の1が3位」というシンプルな規則が、単語の出現頻度、都市の人口、検索ワードといった無関係に見える世界に共通して現れるという、不思議な経験則です。単語ではとくにきれいに現れる一方、都市の人口は国や時代、市町村合併などの影響で崩れることもあります。
なぜそうなるのかは完全には解明されておらず、最小努力の原理、大きいものほど育ちやすい仕組み、でたらめでも生じる統計的な性質など、複数の説が並び立っています。大切なのは、厳密な法則ではなく「偏りの形をつかむ目安」として使うことです。
次の一歩として、身近なランキング、たとえば自分のブログのアクセス数や、よく使うアプリの利用時間などを多い順に並べてみてください。1位と2位、3位の比率を計算すると、ジップの法則がどのくらい当てはまるのかを自分の目で確かめられます。
参考リスト
- Zipf’s law – Wikipedia
- Zipf’s Law for Cities – A Simple Explanation for Urban Populations(Cornell University)
- Why Does Zipf’s Law Break Down in Rank-Size Distribution of Cities?(Kuninaka & Matsushita, 2008)
- 人口移動現象の数値的及び理論的研究 研究成果報告書(三重大学学術機関リポジトリ)
- 都市人口と順位との関係(鈴木武、法政大学 経営志林)
- There is More than a Power Law in Zipf(Scientific Reports, 2012)
- Mathematics: Zipf’s Law and the AOL Query Database(Fourmilab)
- Traffic Log Patterns(Nielsen Norman Group)
- Web Usage Mining in Search Engines(University of Waterloo)
- 検索語の長さの分布に関する論文(SIGIR’08)
- Zipf’s Law for Atlas Models(arXiv)
- On the Range of City Sizes
- Zipf law – Encyclopedia of Mathematics
- 話し言葉とジップの法則に関する論文(PMC)
- 単語の出現頻度に着目した多言語テキストの構造解析(大阪府立大学 修士論文)
- 落語にみるジップの法則:回帰分析とフィラー